WHAT IT LOOKS LIKE
實際畫面
以下每一張都是實機截圖,並且標明是哪一支片。 不同區塊用不同的片,因為沒有一支能同時把每一區都展示到最好—— 標明出處不是禮貌,是不要讓你以為一支片就長這樣。
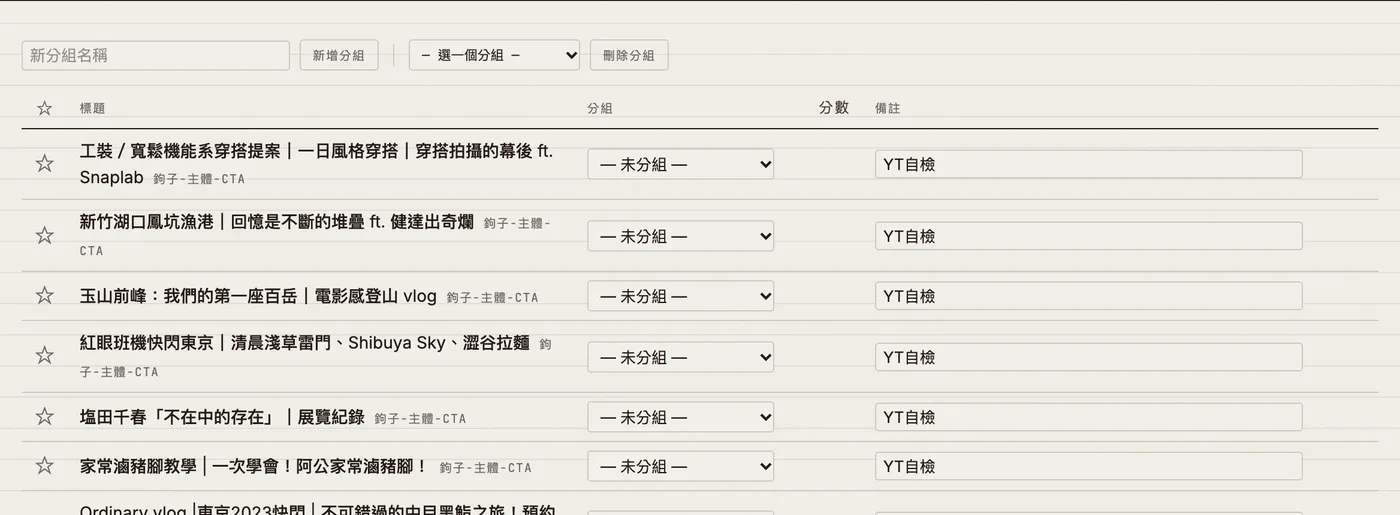
00 · 片庫
LIBRARY一台機器上的所有片。分組、備註、分數都在同一張表上,點一列就進 inspector。表格會隨螢幕寬度伸縮——它是表不是散文,所以寬螢幕就該用滿。
reel-scout view
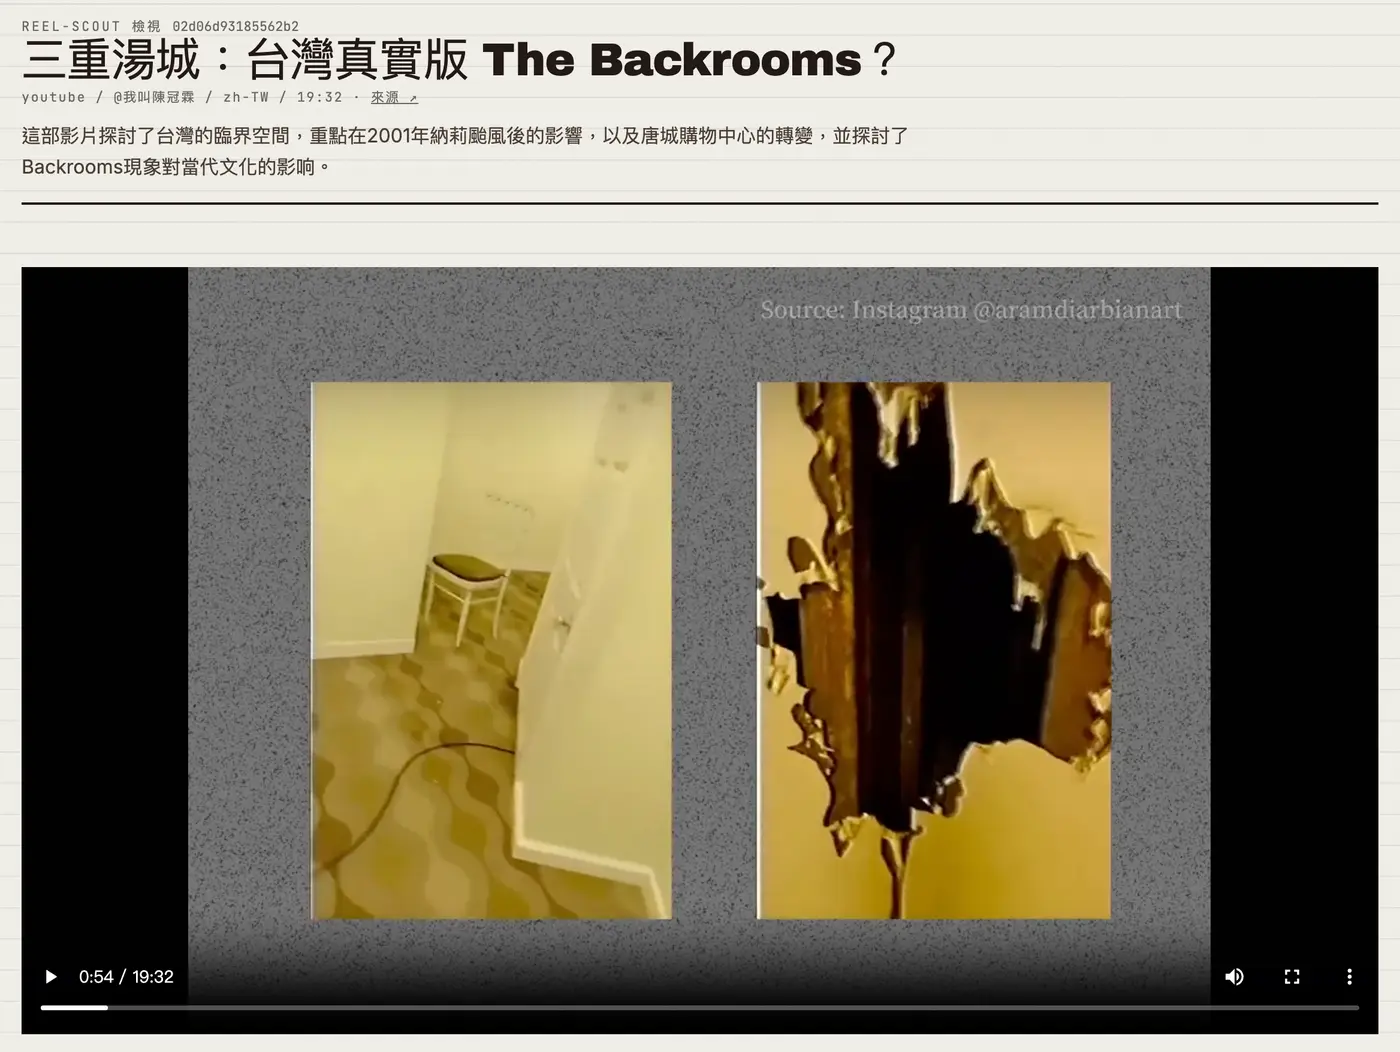
01 · 單片檢視
INSPECTOR影片、標題、平台、時長、原始連結在最上面。底下所有區塊都跟這個播放器同步——點逐字稿的時間、點關鍵影格、點時間軸色帶,都會跳到那一刻。
reel-scout inspect <id>
02 · 波形與進出點
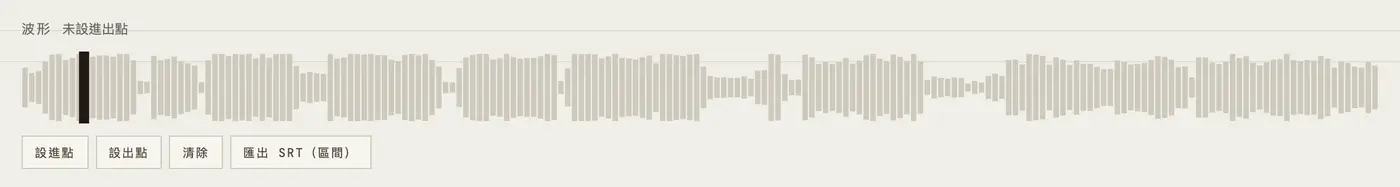
WAVEFORM整支片的音訊波形。可以設進點與出點,然後把那一段匯出成 SRT——看到想用的段落時不必切去別的軟體。
設進點 / 設出點 / 匯出 SRT(區間)
03 · 關鍵影格
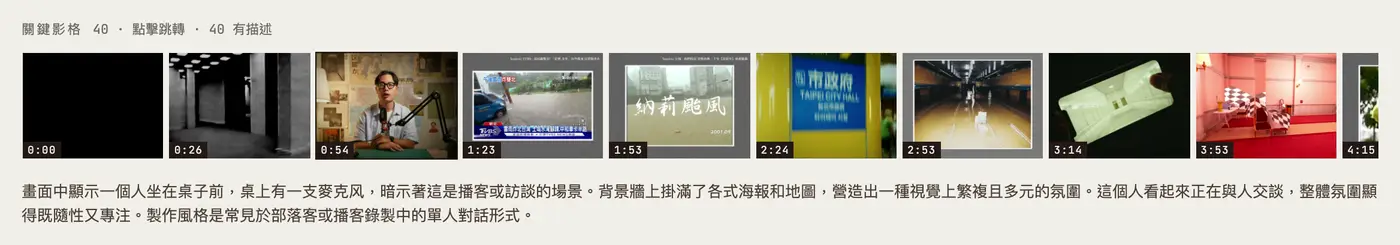
KEYFRAMES按場景變化抽出來的楨,每張帶時間碼、每張都有模型寫的描述。楨數依片長編列預算,首尾各保一張——長片不會只抽到開頭那幾秒。
reel-scout vision <id>
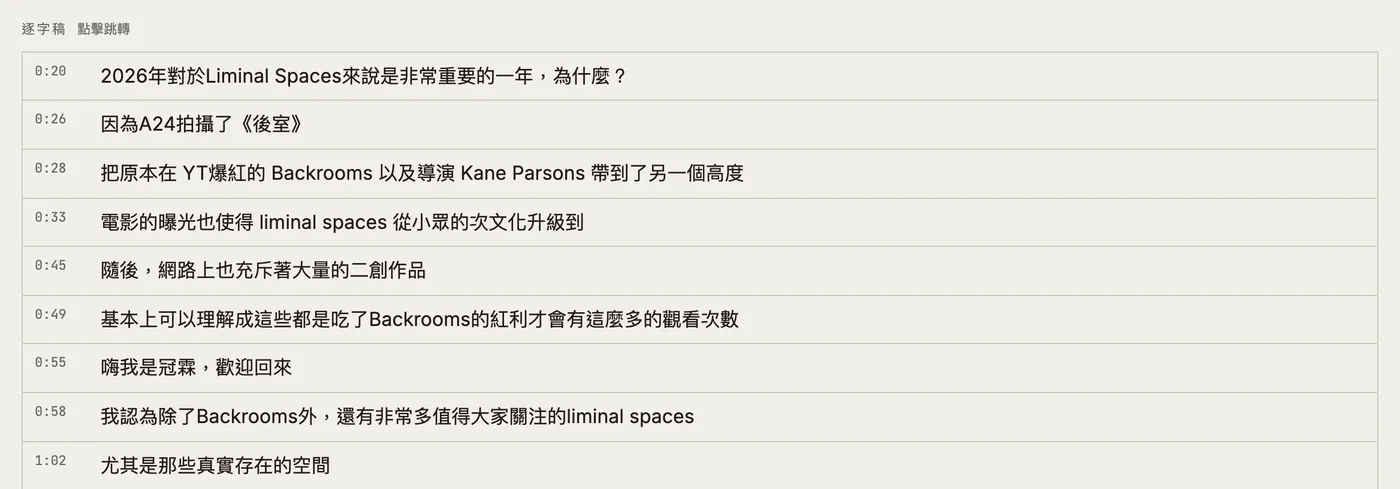
04 · 逐字稿
TRANSCRIPT字幕優先:有原生字幕軌就用它,比重跑一次語音辨識準且快。沒有才走 Whisper。每一句都可以點,點了就跳到那一刻。
reel-scout transcribe <path>
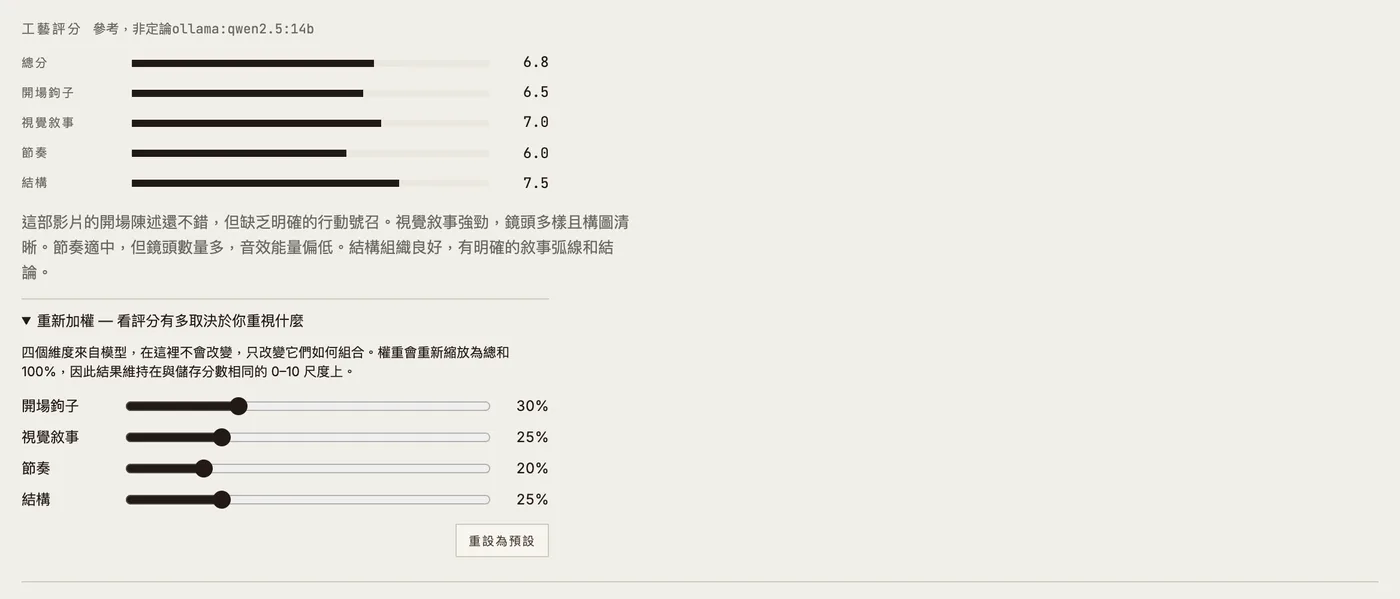
05 · 工藝評分 + 重新加權
CRAFT SCORE四個維度加一個總分,長條是墨色不是紅綠——那是一個資料層,不是一個判決。展開「重新加權」可以現場拖權重,看這支片的評價有多少其實是你自己的偏好。四個維度本身不會變,變的只是它們怎麼組合。
reel-scout score <id>
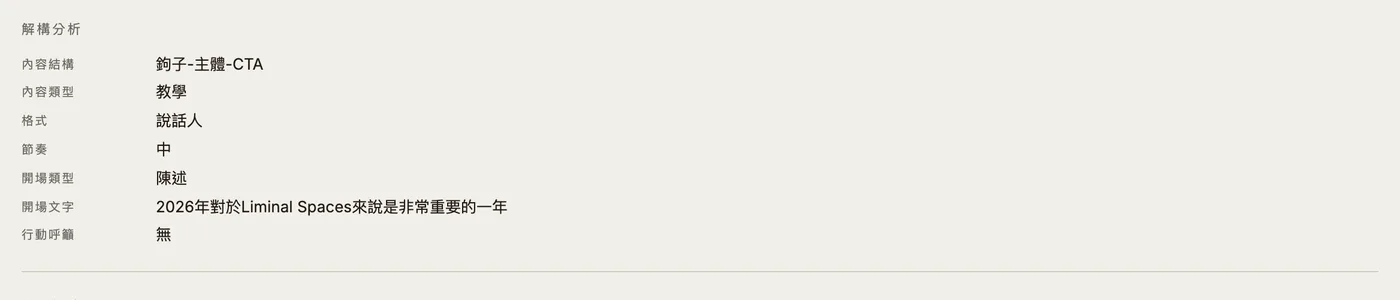
06 · 解構分析
DECODED把前面幾層交給 LLM 合成出來的結構化欄位:內容結構、類型、格式、節奏、開場類型、開場文字、行動呼籲。這是「下次要找那支用三刀開場的片」能變成一次查詢的原因。
reel-scout analyze <url>
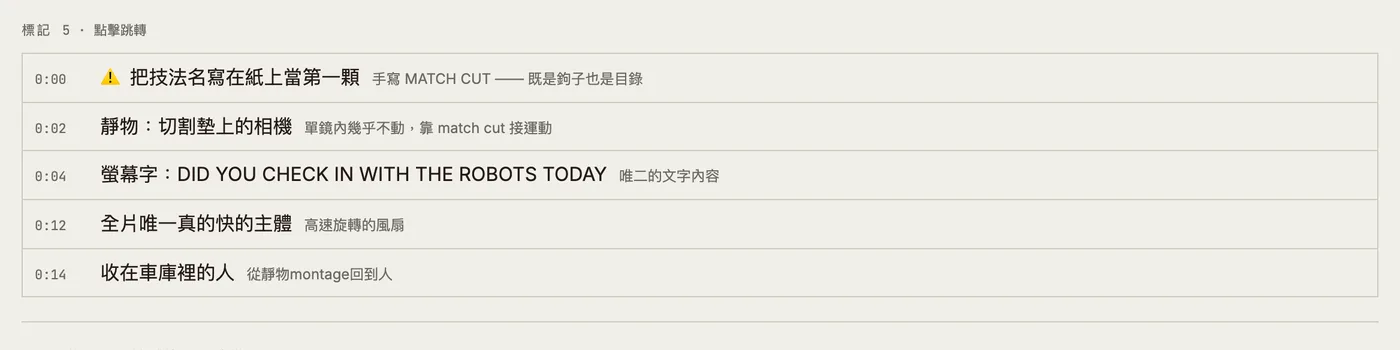
07 · 手工標記
MARKS模型看不出來的東西自己標。時間碼加一句話,之後回來看就知道當時在看什麼——這一層是你的判斷,不是模型的。
reel-scout mark <id> <t> "<說明>"
08 · 鏡頭語法
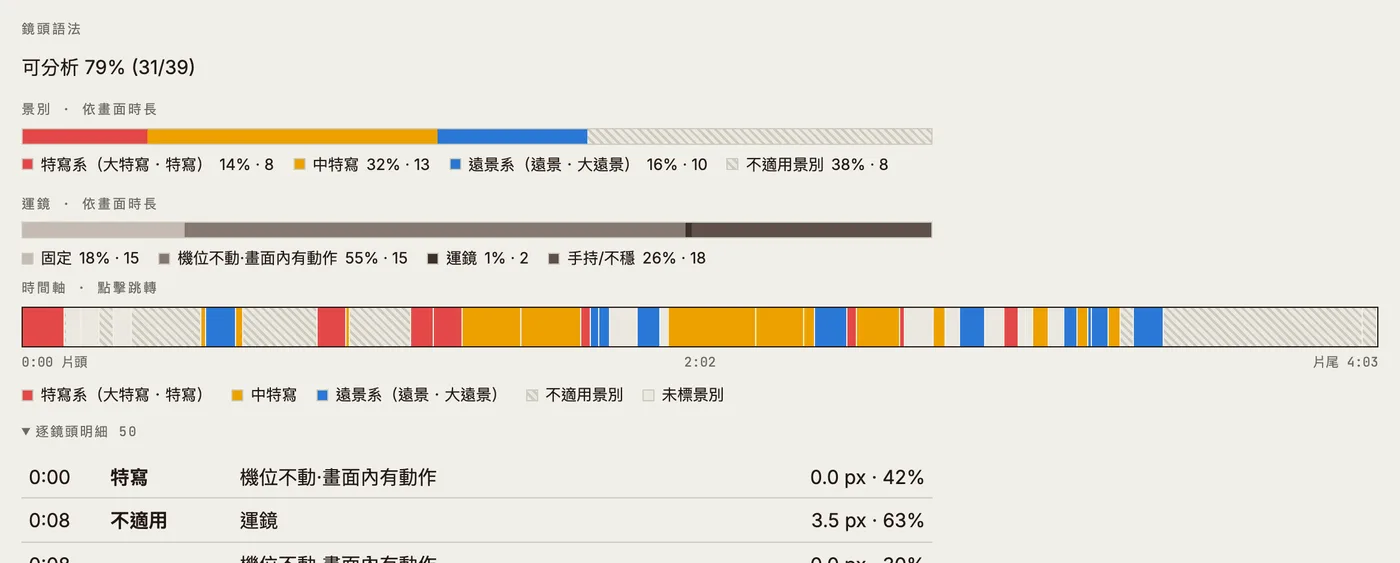
SHOT GRAMMAR全片剪點偵測之後的結果:景別與運鏡各自的分佈,加一條可以點的時間軸色帶。顏色在這裡是刻意的——它是一組封閉可枚舉的分類,不是裝飾。開頭那個「可分析 79%」是誠實的分母:標不出來的鏡頭會算進去,不會被藏掉。
reel-scout shot-size <id>
三個介面,一個殼
THREE SURFACES| 指令 | 是什麼 | 什麼時候用 |
|---|---|---|
| view | 本機伺服器,整個片庫+點進去就是 inspector | 自己翻素材的時候 |
| inspect <id> | 釘住單片的互動檢視 | 要仔細看一支片 |
| export --format bundle | 一支片一個自包含的 HTML:影片、關鍵影格、波形、字型全內嵌 | 寄給別人/當課程教材。對方零安裝,整頁只發一個網路請求 |
它長這樣是刻意的
THE SHELL紙與墨。會說話的東西是關鍵影格、波形和影片本身——外殼要安靜,內容才大聲。 工藝評分的長條因此是墨色而不是紅綠:那是一個資料層,不是一個判決。
唯一刻意用色的是鏡頭語法那條時間軸—— 景別是一組封閉可枚舉的分類(因為要有人照著它去現場執行), 而分類需要能一眼分開,那不是裝飾。
品牌字型隨套件一起出貨(拉丁字重很小;中文按實際用到的字動態 subset), 所以匯出的單檔 HTML 在任何機器上打開都是同一個樣子,不靠對方裝了什麼字體。